Dançarino inicial
A foto 1 substitui o dançarino no início do clipe.
TRÊS FOTOS. UMA DANÇA NO POSTO DE GASOLINA.
Use suas fotos para definir o dançarino inicial, quem grava a selfie e quem dança ao lado do carro. A referência da dança já está incluída.
Explore os modelos do estúdio de vídeo do Rapframe.
Abrir o estúdio de vídeoSeus arquivos permanecem privados.
Requer créditos pagos. Confira o custo antes de gerar.
As três fotos orientam a aparência de cada papel. Este exemplo altera alguns movimentos e o tempo em relação à referência; os novos resultados podem variar.
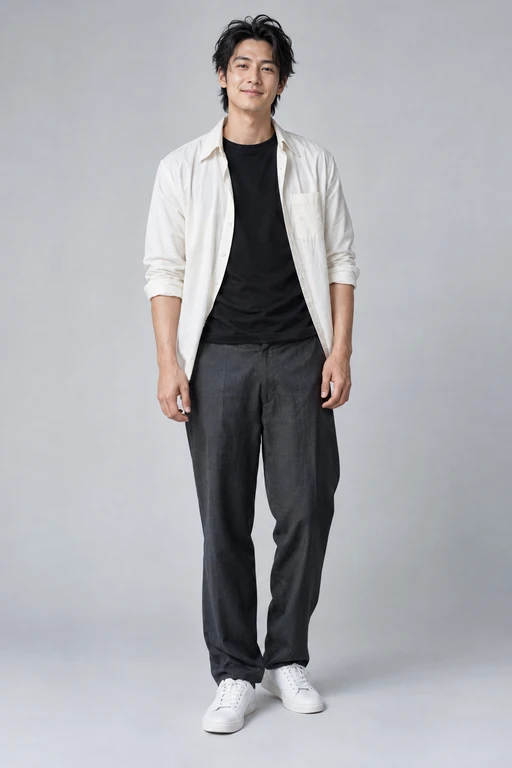
Dançarino inicial
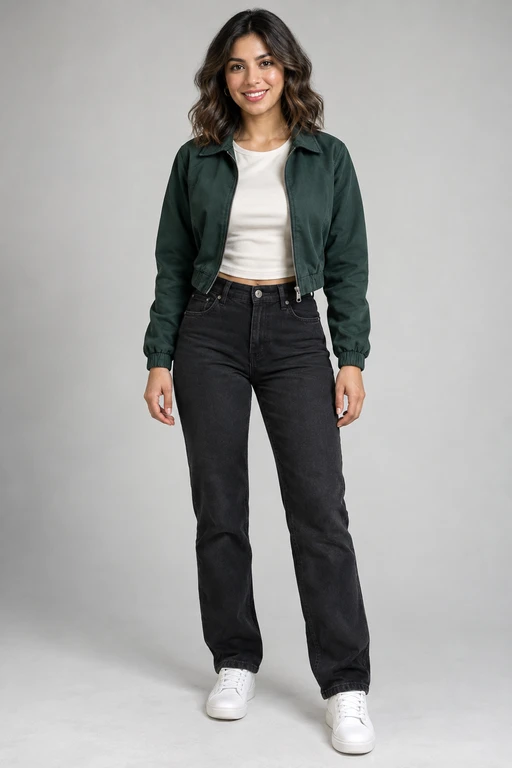
Quem grava a selfie
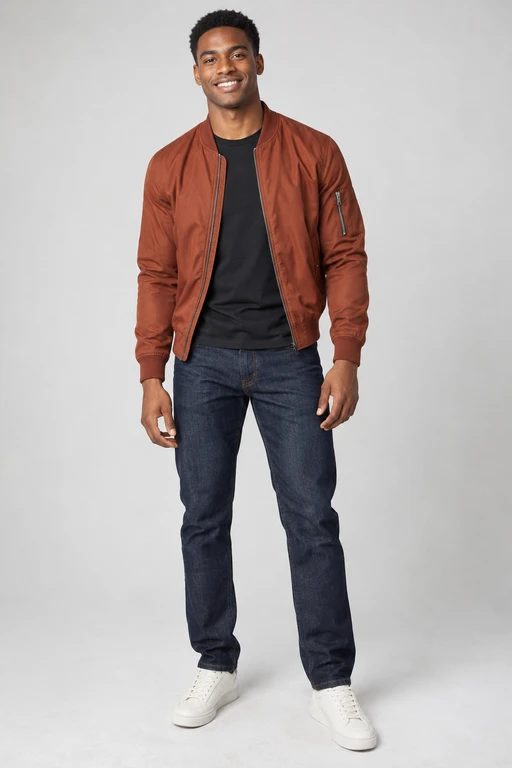
Pessoa que dança ao lado do carro
14,7 segundos · Os movimentos e o tempo podem variar
Gas Station Dance AI recria a dança no posto de gasolina com três personagens à sua escolha. Suas fotos orientam o rosto, cabelo e roupa visível; uma referência integrada guia a dança, a cena e a câmera.
A prévia acima é um exemplo gerado pelo Rapframe. Seu resultado pode variar na aparência, movimento e detalhes do fundo.
A foto 1 substitui o dançarino no início do clipe.
A foto 2 substitui quem grava a parte da selfie.
A foto 3 substitui a pessoa que dança ao lado do carro. Os papéis seguem a ação mesmo quando a câmera se move.
Veja o exemplo gerado por IA para conhecer os três papéis e a ordem deles.
Adicione uma foto nítida de uma pessoa para cada papel indicado. Use fotos diferentes para personagens diferentes ou a mesma pessoa nos três papéis.
Crie seu clipe com créditos pagos; depois, assista e baixe seu MP4. Peça uma mudança na mesma conversa para criar outra versão.
Use uma foto bem iluminada de uma pessoa para cada papel, com rosto nítido e roupa visível. Uma imagem da cintura para cima ou de corpo inteiro dá mais detalhes da aparência ao vídeo. Evite óculos escuros, filtros fortes e pessoas cobrindo umas às outras.
Escolha 10 ou 15 segundos e o formato nas configurações. O trecho inicial correspondente da referência é usado sem estender nem repetir a rotina.
Assista ao resultado inteiro e depois baixe. O formato padrão é vertical para publicações curtas nas redes.
Peça uma mudança específica na aparência ou no movimento na mesma conversa. Cada nova geração consome créditos pagos.
Antes de compartilhar, confira os rostos, as roupas, as mãos e a atribuição dos três papéis. Uma foto nítida e uma instrução curta e específica podem ajudar. Os resultados variam, e a referência não garante movimentos nem tempo exatos.
É uma sequência de dança em um posto de gasolina com um dançarino inicial, uma parte de selfie e uma pessoa dançando ao lado de um carro. Esta ferramenta permite trocar esses três papéis usando suas fotos.
Três fotos, uma para cada papel indicado. A foto 1 é o dançarino inicial; a foto 2, quem grava a selfie; e a foto 3, quem dança ao lado do carro.
Sim. Envie a foto da mesma pessoa nos três espaços. Cada espaço continua associado ao seu próprio papel na dança.
Não. A referência de movimento está incluída. Adicione instruções apenas se quiser uma aparência específica ou uma pequena mudança visual.
Escolha 10 ou 15 segundos. Ambas as durações incluem os três papéis; quem dança ao lado do carro aparece brevemente na versão de 10 segundos. Escolha 15 segundos para dar mais tempo a cada papel.
O som de referência incluído é adicionado ao clipe exportado. Ouça o resultado antes de compartilhar; os movimentos e o tempo podem variar.
Compre um pacote de créditos de pagamento único. A geração custa 20 créditos por segundo: 100 por 5 segundos ou 200 por 10 segundos. Gerações com falha devolvem os créditos reservados. Sem assinatura nem renovação automática.
Peça uma mudança específica na mesma conversa. Foque no papel que deseja ajustar. Os detalhes e movimentos gerados com IA ainda podem variar.
Use suas fotos para definir o dançarino inicial, quem grava a selfie e quem dança ao lado do carro. A referência da dança já está incluída.
Crie sua dança no posto de gasolina